Wendy Günther, AI Strategie Consultant bij het Rijks ICT Gilde, over supervised vs unsupervised leren en over het effectief managen van unsupervised AI tijdens de ontwikkeling en implementatie.
Wendy Günther
Eén van de problemen in het vakgebied van Artificial Intelligence (AI) is dat AI een enorm containerbegrip is geworden. In de praktijk zijn er verschillende soorten AI die ook verschillende behandelingen verdienen. In deze blog ga ik in op een onderbenutte en onderbelichte soort: unsupervised AI. Ik zal uitleggen wat eronder wordt verstaan, ga in op welk nut en uitdagingen deze soort kent en ik geef tips over hoe we unsupervised AI het beste kunnen supervisen.
Basisbegrippen: supervised vs unsupervised leren
AI “leert” met behulp van machine learning-technieken: ontwikkelaars bouwen AI-modellen door middel van algoritmes die patronen kunnen ontdekken in historische data. Op basis van die patronen kunnen modellen voorspellingen doen over nieuwe input data, zonder daar expliciet voor te zijn geprogrammeerd. Er zijn echter verschillende manieren waarop modellen leren om patronen te herkennen. Traditioneel maakt men onderscheid tussen supervised en unsupervised leren (zie figuur 1 voor een gesimplificeerde weergave van het verschil tussen deze twee vormen).
In het geval van supervised leren wordt een model getraind om een specifieke, vooraf gedefinieerde uitkomst te voorspellen. Een voorbeeld is het trainen van een AI model dat frauduleuze transacties detecteert. De vooraf gedefinieerde uitkomst is in dit geval: wel óf geen frauduleuze transactie. Om een model te trainen dat deze uitkomst kan voorspellen, is een historische dataset nodig met daarin voorbeelden van zowel frauduleuze als niet-frauduleuze transacties, die ook als zodanig gelabeld zijn. Aan de hand van deze voorbeelden met annotaties kan een model met behulp van een algoritme “leren” welke combinaties van kenmerken (bijv. tijdstip, plaats en bedrag) typerend zijn voor frauduleuze transacties.
In het geval van unsupervised leren is er geen vooraf gedefinieerde uitkomst. In plaats daarvan worden algoritmes ingezet die verbanden in data kunnen ontdekken op basis van verschillen en overeenkomsten. In het geval van transactiedata, bijvoorbeeld, zou een model ontwikkeld kunnen worden dat verschillende soorten transacties groepeert of “clustert”, puur op basis van overeenkomende kenmerken. Transacties zouden vervolgens als verdacht kunnen worden aangemerkt wanneer ze op basis van bepaalde kenmerken sterk afwijken van andere, ogenschijnlijk normale transacties.
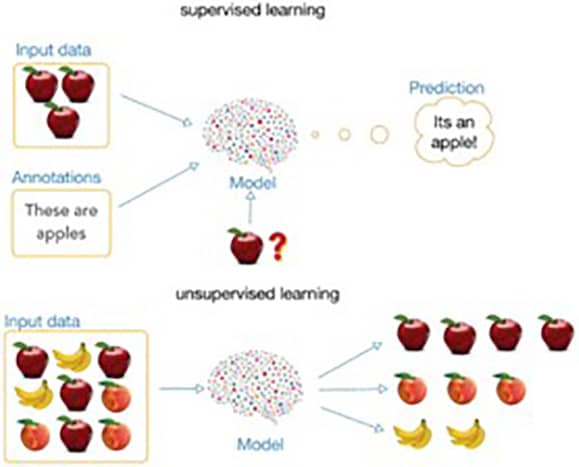
Figuur 1: Verschil tussen supervised en unsupervised leren. Overgenomen van Ma et al. (2018). In het geval van supervised leren wordt een model getraind om appels te herkennen. In het geval van unsupervised leren clustert een model datapunten op basis van overeenkomende kenmerken zoals vorm en kleur.
Hedendaagse taalmodellen zoals bijvoorbeeld de modellen achter ChatGPT bouwen in zekere zin voort op de principes van unsupervised leren, door patronen, taalstructuren en relaties te leren uit enorme hoeveelheden ongelabelde tekstuele data (zie figuur 2 voor de relatie tussen deze vormen van AI).
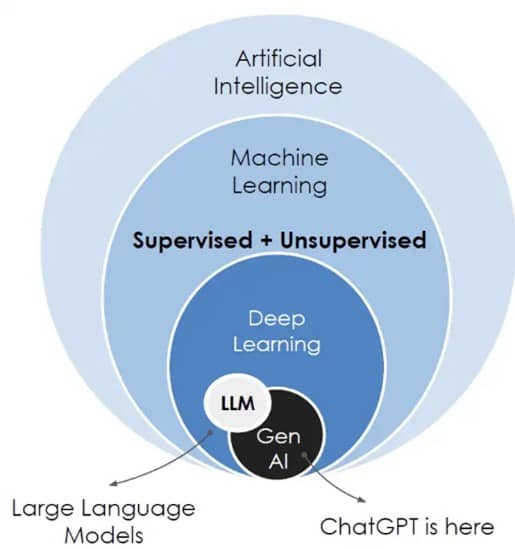
Figuur 2: Relatie tussen verschillende soorten AI. Overgenomen van Malandruccolo (2024).
Waarom unsupervised AI inzetten? Een praktisch voordeel van unsupervised AI is dat je het kunt inzetten wanneer er niet genoeg gelabelde data voorhanden is. Maar misschien wel het grootste voordeel is dat het kan leiden tot nieuwe inzichten. Zo kan het gebruikt worden om andere afwijkende patronen te ontdekken (bijv. afwijkend menselijk gedrag), om documenten te clusteren (bijv. beleidsdocumenten groeperen), om de publieke opinie in kaart te brengen (bijv. welke onderwerpen leven er op social media), om klantsegmenten te identificeren en nog veel meer. Men hoeft hierbij niet vast te houden aan vooraf gedefinieerde categorieën en kan zelfs verrast worden door nieuwe, onvoorziene clusters.
De uitdagingen van unsupervised AI
Het inzetten van unsupervised AI brengt echter ook een aantal unieke uitdagingen met zich mee.
Allereerst zijn unsupervised modellen zeer gevoelig voor keuzes die tijdens de ontwikkeling worden gemaakt. Hoewel men van tevoren geen uitkomst hoeft te definiëren, zijn er wel andere zaken die bepaald moeten worden. Zo is er een grote variëteit aan algoritmes waar ontwikkelaars uit kunnen kiezen, die fundamenteel kunnen verschillen in hoe zij clusters onderscheiden. Ook vereisen veel algoritmes dat de ontwikkelaar van tevoren bepaalde keuzes maakt, zoals hoeveel clusters het model moet onderscheiden. Bovendien worden de uitkomsten sterk beïnvloed door willekeur (randomness). Om deze redenen is het reëel dat twee ontwikkelaars op basis van dezelfde data, onafhankelijk van elkaar tot totaal verschillende modellen en resultaten komen.
De tweede uitdaging zit hem dan ook in het evalueren van unsupervised modellen. Als verschillende keuzes kunnen leiden tot verschillende modellen en resultaten, hoe beslist men dan welk model “het beste” is? In het geval van supervised modellen zijn er allerlei statistieken om te kwantificeren hoe goed een model is — je hebt immers een historische dataset voorhanden die je kunt gebruiken om te testen of je model de verwachte uitkomsten ook daadwerkelijk goed voorspelt (bijv. of een “frauduleuze transactie” ook echt als zodanig wordt gecategoriseerd). In het geval van unsupervised modellen is er echter geen sprake van een juiste of onjuiste voorspelling, maar van een aantal potentieel relevante opties.
AI-modellen worden bovendien vaak gezien als een “black box” - het kan bijvoorbeeld onduidelijk zijn waarom de ene transactie als mogelijk frauduleus wordt aangemerkt en de andere niet. Voor unsupervised modellen is het nóg lastiger om na te gaan waarom bepaalde datapunten samen worden gegroepeerd en anderen niet: welke overeenkomsten of verschillen in kenmerken doorslaggevend zijn, is moeilijk te achterhalen.
Unsupervised AI managen
Vanwege de uitdagingen blijft unsupervised AI in de praktijk vaak onderbenut en dat is zonde, omdat het ook veel kansen biedt. De sleutel zit hem in het effectief managen van unsupervised AI tijdens de ontwikkeling en implementatie. Daarom hieronder drie tips:
1. Domeinkennis is cruciaal
Het is allereerst cruciaal dat domeinkennis wordt meegenomen in de ontwikkeling. Omdat verschillende keuzes kunnen leiden tot verschillende modellen, is het belangrijk dat deze keuzes worden gemaakt met begrip van de specifieke context en toepassing. In het geval van unsupervised leren voor fraudedetectie, bijvoorbeeld, moet een ontwikkelaar kunnen begrijpen of ogenschijnlijk “afwijkende transacties” ook daadwerkelijk indicatief zijn voor fraude, of dat er een andere reden is waarom deze transacties afwijkend zijn. Het is dan ook noodzakelijk dat ontwikkelaars niet alleen zelf over domeinkennis beschikken, maar ook nauw samen werken met domein experts die resultaten kunnen interpreteren en modellen kunnen evalueren. Het doel is om op een contextueel niveau te kunnen onderzoeken op basis van welke “gelijkenissen” en “verschillen” datapunten zijn gegroepeerd. Bestaande instrumenten (bijv. het IAMA) benadrukken dat het betrekken van domeinexperts wenselijk is. In het geval van unsupervised leren is betrokkenheid van domein experts echter niet alleen wenselijk, het is essentieel.
2. Experimenteren is noodzaak
Ook is het noodzakelijk om tijdens de ontwikkeling te experimenteren met verschillende keuzes. Om de “juiste” keuze te maken is het belangrijk om te weten wat de invloed van een bepaalde keuze is. Dit kan alleen worden onderzocht door er actief mee te experimenteren. Leidt een ander algoritme bijvoorbeeld tot andere groeperingen? En krijgen we wellicht andere resultaten als we het algoritme laten zoeken naar meer, of juist minder clusters? In bestaande instrumenten voor ontwikkeling (bijv. de Handreiking non-discriminatie by design) wordt vaak benadrukt dat AI ontwikkeling een iteratief proces is. Maar experimenteren gaat verder dan itereren: het vereist een actieve manier van onderzoeken, het testen van verschillende configuraties en het interpreteren van zeer veel verschillende modellen en uitkomsten.
Bovendien is het doel van een dergelijke werkwijze niet alleen het identificeren van bijvoorbeeld ongewenste vooroordelen. Hoewel dat uiteraard ook zeer belangrijk is, dient experimenteren een fundamenteler belang: Er is namelijk niet één optimale configuratie of één waarheid waar unsupervised modellen naar convergeren - er zijn meerdere opties en het is essentieel om de verschillende mogelijke waarheden in kaart te brengen, om zo gezamenlijk geïnformeerde keuzes te kunnen maken.
3. Transparant zijn over overwegingen is een vereiste
Ook is het belangrijk om keuzes transparant te maken, niet om “reproduceerbaarheid” te faciliteren, maar om verantwoording te kunnen afleggen. In het geval van unsupervised AI zou de focus bij voorkeur moeten liggen op het documenteren van onderliggende (soms onderbewuste) assumpties, intenties en overwegingen die een rol hebben gespeeld in het maken van keuzes tijdens de ontwikkeling. Belangrijk daarbij is om na te gaan welke verschillende perspectieven zijn meegenomen in de overweging en welk perspectief leidend. Ook is het noodzakelijk om te reflecteren op de limitaties van het model. Door te focussen op een bepaald model worden alternatieve waarheden wellicht over het hoofd gezien. Tot slot is het belangrijk om keuzes regelmatig opnieuw te evalueren in het licht van een veranderende domein context.
Kortom, unsupervised AI is tot op heden onderbenut en onderbelicht. Maar dit hoeft niet zo te zijn: unsupervised AI kan zeer waardevol zijn en biedt veel kansen voor organisaties, mits het op de juiste manier ‘gesupervised’ wordt.
|
Dit artikel is gebaseerd op het wetenschappelijk paper “Trustworthiness in Computational Theory Construction: Dimensionalization and Category Surfacing”. Wendy Günther is momenteel werkzaam als AI Strategie Consultant bij het Rijks ICT Gilde. Als assistent professor bij het KIN Center for Digital Innovation, Vrije Universiteit Amsterdam (VU) heeft zij onderzoek gedaan naar de effectieve en verantwoordelijke ontwikkeling en implementatie van data-gedreven oplossingen, inclusief Machine Learning modellen en Artificial Intelligence. Zij ontwikkelde samen met haar co-auteurs Mayur Joshi en Panon Constantinides een framework voor de betrouwbare inzet van unsupervised ML algoritmes voor onderzoeksdoeleinden. Het huidige artikel is deels gebaseerd op die publicatie, vertaald naar de praktijk. |